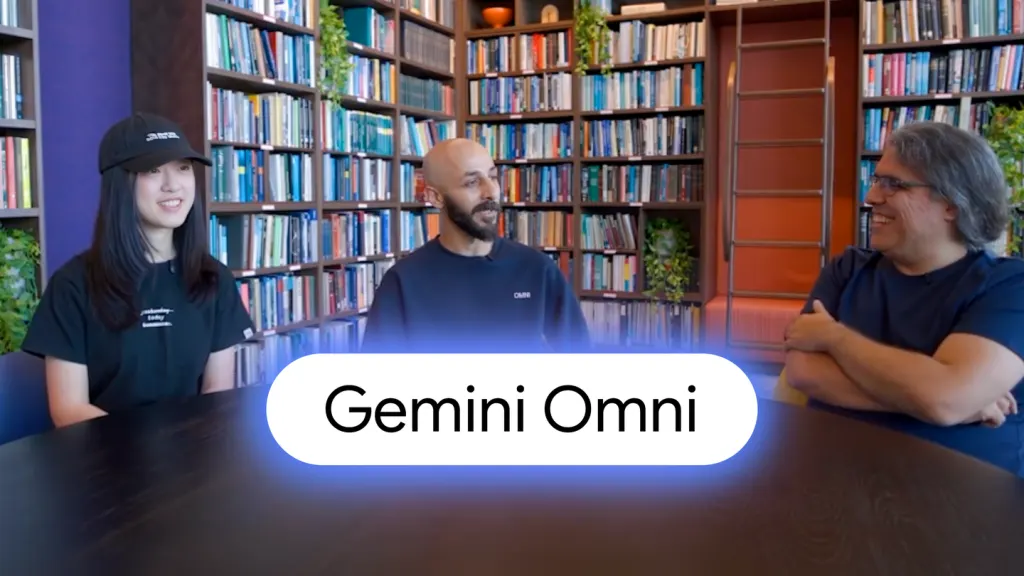
Omni 先从“对话式视频创作”切入
Google 将 Gemini Omni 描述为能够从多种输入出发进行创作的新模型体系,首个公开版本 Gemini Omni Flash 重点落在视频生成与编辑。核心体验不是让创作者在多个独立工具之间切换,而是尽量把“生成—修改—继续调整”收敛到同一段对话中。
文章采访了三位 Google DeepMind 团队成员:研究科学家 Mohammad Babaeizadeh、产品经理 Anish Nangia 和研究工程师 Sarah Xu。他们讨论了 Omni 的长期方向、为什么首先选择视频,以及团队如何理解创作者真正需要的交互方式。
重点在可持续操控,而不是一次性出图
文章中的演示刻意选择了换发型、把人物变成树懒、把猫放进场景等轻松例子。它们传递的产品信号比“某个单次生成效果”更重要:用户可以围绕同一个创作对象持续提出修改,模型需要在多轮过程中保留意图并响应新的约束。
这篇内容并不是一份模型基准评测,因此不应该被包装成“性能排名”。更准确的理解是,Google 正在把多模态生成从一次性调用推进到连续、可操控的创作工作流。
AI 智库判断
对创作者和工具产品而言,下一阶段的竞争点会从“第一次生成有多惊艳”逐步转向“能否稳定地改、连续地改、跨输入类型地改”。如果上下文连续性和可操控性做得足够好,模型才更可能进入真实生产流程,而不是停留在演示层。
本文为 AI 智库基于 Google DeepMind on The Keyword 原文整理的编辑摘要;涉及产品能力、价格或可用性时,请以原始来源的最新说明为准。 Google DeepMind on The Keyword